Lire les fan-outs de ChatGPT pour écrire selon l'intention de recherche
Avant de répondre avec une recherche web, ChatGPT découpe la question en plusieurs requêtes : ses fan-outs. Les lire montre ce qu'un moteur IA estime nécessaire pour répondre. Le Fan-out viewer les rend lisibles, pour s'en servir au moment de choisir le sujet et le plan d'un article.
Quand on pose une question à ChatGPT avec la recherche web, il la reformule en plusieurs requêtes, lance chacune, lit les résultats, puis rédige une réponse qui n'en cite qu'une partie. Ces requêtes dérivées s'appellent des fan-outs, d'après l'image de l'éventail.
Pour qui écrit pour être trouvé, ces requêtes complètent Google Suggest. Les suggestions montrent ce que les gens tapent ; les fan-outs, ce qu'un moteur IA va chercher pour construire sa réponse, y compris ce que la question ne disait pas.
Ce que contient une conversation
La page de ChatGPT reçoit chaque conversation sous forme d'un fichier JSON. On le trouve dans les outils de développement du navigateur, onglet Réseau, sur la requête de la conversation. Il contient, en plus du texte échangé, les requêtes lancées par le modèle, les résultats obtenus, groupés par lot de requêtes, et les références citées dans la réponse.
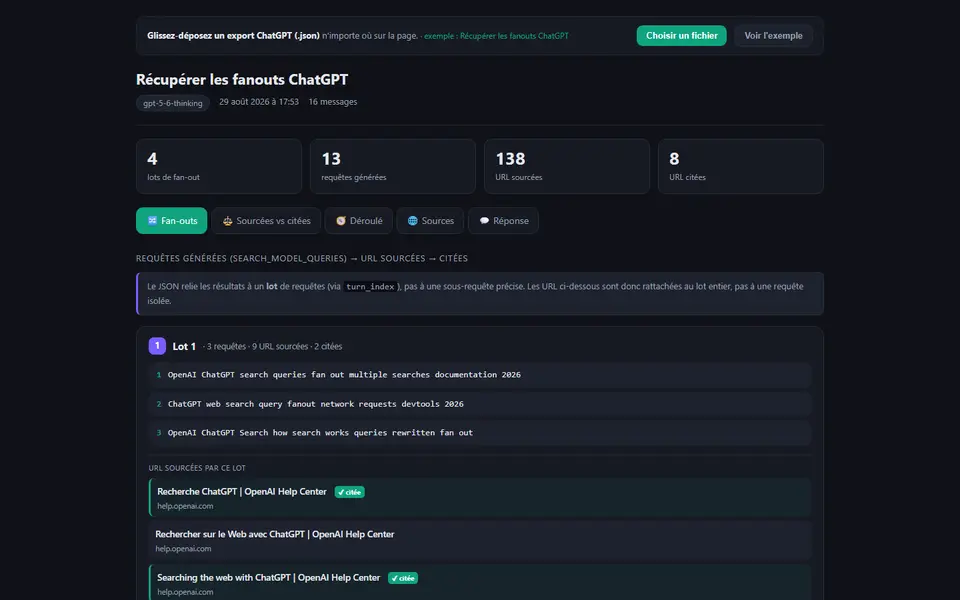
Lu tel quel, ce fichier est illisible : plusieurs centaines de kilooctets d'objets imbriqués. Le Fan-out viewer est une page HTML autonome dans laquelle on glisse ce fichier. Elle l'affiche en cinq onglets :
- Fan-outs : les requêtes, lot par lot, avec sous chaque lot les pages trouvées, et un badge sur celles que la réponse cite.
- Sourcées vs citées : la comparaison entre ce que le modèle a lu et ce qu'il a retenu.
- Déroulé : l'ordre des étapes de la conversation.
- Sources : les sites trouvés, regroupés par domaine.
- Réponse : le texte final, avec ses citations.
La page le précise : le fichier rattache les résultats à un lot de requêtes. On sait quelles pages un lot a ramenées, sans savoir laquelle de ses requêtes les a trouvées.
Un exemple : les devis d'un artisan
Le 29 août 2026, j'ai demandé à ChatGPT de chercher sur Internet comment automatiser les devis d'un artisan avec l'IA. Le modèle a lancé cinq requêtes. La première cherche des logiciels de devis à l'IA. Deux autres cherchent la génération de devis à partir de photos de chantier ou de la voix, et les branchements possibles avec n8n ou Make. Les deux dernières cherchent les mentions obligatoires d'un devis de travaux, sur Service-public et du côté de la DGCCRF.
La question ne parlait pas de droit, et le modèle est quand même allé chercher ce qu'un devis doit contenir. Sur plus d'une centaine de pages trouvées, la réponse n'en cite qu'une poignée. Parmi les pages citées figurent Service-public, les impôts (pour le taux de TVA des travaux dans les logements), France Num, la documentation d'un logiciel de comptabilité, un fil du forum de n8n et plusieurs éditeurs de logiciels de devis.
Ce que j'en tire pour écrire
Un article qui vise la question « comment automatiser les devis d'un artisan avec l'IA » et qui ne parle que d'outils manque une partie de ce que le moteur estime nécessaire. Les fan-outs se lisent comme une liste de sous-intentions : chacune peut devenir un intertitre, un encadré ou une page satellite.
L'onglet « Sourcées vs citées » répond à une seconde question : quel type de page le modèle retient. Dans cet exemple, les sites publics et les documentations techniques passent le filtre, à côté des pages produit des éditeurs.
Les fan-outs montrent ce qu'un moteur IA cherche pour répondre, y compris ce que la question ne disait pas.
Les limites à garder en tête
- Un format interne : ce JSON n'est pas une interface documentée par OpenAI. Ses champs peuvent changer ou disparaître d'une version à l'autre, et le viewer avec eux.
- Un échantillon : une conversation montre un tirage. Reposée, la même question peut produire d'autres requêtes ; il faut plusieurs conversations avant de conclure.
- Un seul moteur : ce que fait ChatGPT ne dit rien de ce que font les autres moteurs IA.
- Aucun volume : les fan-outs disent ce que le modèle cherche, pas combien de personnes posent la question.
Vers un processus d'écriture
Le viewer est la première brique. Les articles de ce site partent déjà d'une requête principale, choisie d'après des recherches réelles et datées : les suggestions de Google et la page de résultats. L'étape suivante est d'ajouter les fan-outs à cette recherche, avant d'écrire.
Le Fan-out viewer est en service. Il tient en un seul fichier HTML et contient une conversation d'exemple, pour voir ce qu'il affiche avant d'y glisser la sienne.