Évaluer un modèle d'IA pour son entreprise : les essais en mer de la montre H4
En 1714, le Parlement britannique fixe par écrit l'écart toléré et l'épreuve en mer avant qu'aucune solution n'existe. Les essais de la montre H4 montrent comment évaluer un modèle d'IA pour son entreprise : un seuil, une épreuve proche de l'usage, et une seconde passe.

En 1714, le Parlement britannique vote une loi sur un problème que personne ne sait résoudre : trouver la longitude d'un navire en pleine mer. Elle promet 10 000 livres à qui la déterminera à un degré près, soit 60 milles géographiques, et jusqu'à 20 000 livres à 30 milles près. Elle fixe aussi l'épreuve : une traversée jusqu'à un port des Antilles choisi par les commissaires que nomme la loi, sans perdre la longitude au-delà de ces limites.
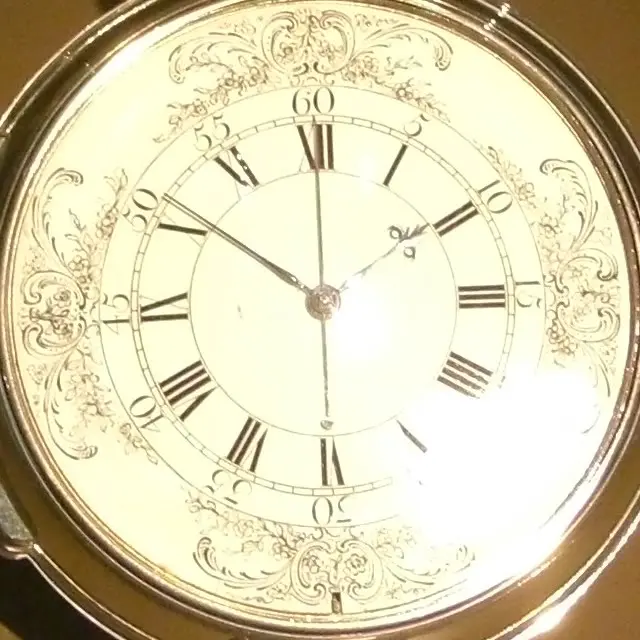
Près d'un demi-siècle plus tard, John Harrison, menuisier du Yorkshire devenu horloger, achève une grosse montre, H4. Fin 1761, son fils William l'embarque sur le Deptford, à destination de la Jamaïque, où le navire arrive en janvier 1762. Une fois corrigée de la marche quotidienne déclarée avant le départ, la montre retarde de 5 secondes sur l'heure établie par les observations faites sur place. D'après le calcul de l'historien Rupert Gould, cela fait un peu moins d'un mille d'erreur, quand la loi en permettait trente.
Les commissaires jugent l'essai insuffisant, le résultat pouvant tenir du hasard, et demandent un second voyage. Cette fois, l'astronome Nevil Maskelyne part en avance pour mesurer la longitude de la Barbade, et William le suit avec H4 en mars 1764. Gould relève à l'arrivée un écart de 38,4 secondes en sept semaines, soit 9,6 milles. En février 1765, les commissaires reconnaissent que la montre a tenu la limite la plus stricte de la loi. Évaluer un modèle d'IA pour son entreprise pose les mêmes questions dans le même ordre : quel écart tolérer, sur quelle épreuve, et ce que prouve un seul bon résultat.
Le mot que la loi de 1714 laissait flou
La loi chiffrait l'écart et nommait l'épreuve avant qu'un candidat se présente. La récompense est due quand la méthode a été « essayée et jugée praticable et utile en mer ». L'exactitude se mesurait en milles ; personne n'avait chiffré le « praticable ». En 1765, les commissaires le traduisent après coup : 10 000 livres quand Harrison aura expliqué le principe de sa montre, le reste quand d'autres horlogers sauront en fabriquer de semblables. La copie commandée à Larcum Kendall, K1, coûte 500 livres ; d'après Jonathan Betts, spécialiste d'horlogerie au National Maritime Museum, cinquante montres à ce prix valaient un vaisseau de ligne de deuxième rang.
Écrire la décision et les seuils avant le premier test
Le choix d'un modèle d'IA se fait souvent dans l'ordre inverse : on consulte un classement public, on essaie quelques questions, puis on juge si c'est « assez bien » après avoir lu les réponses. Le guide d'OpenAI sur les évaluations range cette évaluation « à l'impression » parmi les erreurs. Le niveau exigé glisse alors vers ce que le modèle sait faire.
Commencez par la décision que le test doit trancher, en une phrase : « remplacer la saisie des factures fournisseurs par une extraction automatique, relue par la comptable ». Elle dit quoi mesurer. Écrivez ensuite un seuil par type d'erreur, car les erreurs ne coûtent pas la même chose, et faites-le signer par la personne qui vivra avec elles, ici la comptable. La documentation d'Anthropic sur les critères de réussite va dans ce sens : des critères précis et mesurables, sur plusieurs dimensions, dont la part d'erreurs graves parmi toutes les erreurs.
Pour une PME de soixante personnes qui teste un modèle sur 200 factures, la grille pourrait ressembler à ceci (exemple hypothétique) :
- Montant ou IBAN faux : une fois au plus, et toujours repéré à la relecture. Au-delà, le modèle est écarté, quelle que soit sa moyenne.
- Date ou numéro de facture mal lu : cinq erreurs tolérées, que la comptable voit au rapprochement bancaire.
- Libellé abrégé ou reformulé : sans conséquence, non compté.
Notez le « praticable » de votre cas, la ligne qui manquait en 1714 : le coût par facture, le délai de traitement, et la personne qui ajustera le réglage quand un fournisseur changera de modèle de facture. Un modèle exact que personne ne sait entretenir est dans la situation de H4 en 1765 : il tient le seuil, mais on ne peut pas en équiper la flotte.
Une épreuve qui ressemble à la traversée
La loi exigeait que la montre fasse ses preuves en mer, là où elle servirait, avec le roulis et les écarts de température. Les classements publics mesurent des tâches choisies par d'autres, sur d'autres documents que les vôtres, et OpenAI met en garde contre les indicateurs trop génériques.
Votre traversée est un jeu d'essai tiré de vos dossiers : cinquante à cent cas des trois derniers mois, dans la proportion où ils arrivent, cas difficiles compris (une facture scannée de travers, un avoir, un document en anglais). Pour chaque cas, la personne qui fait le travail écrit la réponse attendue avant que le modèle ne tourne.
Reste la référence. À la Jamaïque, les 5 secondes de H4 dépendaient de deux nombres établis par des hommes : la marche déclarée au départ et l'heure observée à l'arrivée. Vos réponses attendues ont leur propre marge d'erreur. Faites relire une partie du jeu par une deuxième personne, et quand les deux ne s'accordent pas, marquez le cas comme ambigu au lieu de le compter comme une faute du modèle. La documentation d'Anthropic cite ces cas où même des humains peinent à se mettre d'accord.
Ce qu'un seul bon essai prouve
Un seul voyage donne une seule mesure, et une montre peut finir juste parce que ses erreurs se sont compensées en route. C'est le hasard qu'invoquaient les commissaires après la Jamaïque.
Un modèle de langage pose ce problème plus fortement : il ne donne pas toujours la même réponse à la même question, ce que rappelle le guide d'OpenAI. Une passe réussie sur cinquante cas vaut le voyage à la Jamaïque. Sur cinquante cas, deux réponses de plus ou de moins font quatre points de pourcentage, et l'écart entre deux modèles peut tenir dans cette marge. Avec des chiffres hypothétiques : le modèle A obtient 47 bonnes réponses sur 50 à la première passe, le modèle B 45. Sur trois passes, A fait 47, 44 et 45, B fait 45, 46 et 45. L'avance de A tenait au premier voyage.
Prévoyez donc le second voyage avant le premier. Faites tourner le jeu trois fois et relevez les cas dont la réponse change d'une passe à l'autre : ce sont eux qu'il faudra faire relire en production. Gardez un second jeu, tiré de la même façon, que personne ne regarde pendant les réglages du prompt ; il ne sert qu'une fois, à la fin, comme la Barbade. Écrivez enfin la règle de décision : le seuil doit tenir sur chaque passe et sur le second jeu. Décidez aussi d'avance ce que vous ferez d'un résultat juste au seuil : élargir le jeu, lancer un pilote de deux semaines avec relecture complète, ou renoncer.
Harrison, génie méprisé ? La légende et ses limites
Le récit le plus répandu vient du livre de Dava Sobel, Longitude (1995), dont le sous-titre fait de Harrison un « génie solitaire » : selon l'historien Seb Falk, un héros incompris face à un astronome royal, Maskelyne, présenté en méchant. Les archives des commissaires nuancent ce récit. Nommés par la loi, ils ne forment pas un comité permanent : ils se réunissent pour la première fois en 1737 et ne prennent le nom de « Board of Longitude » que dans les années 1760. Dès 1737, ils accordent à Harrison 500 livres pour une deuxième horloge. Selon Falk, la montre et la méthode des distances lunaires défendue par Maskelyne avaient toutes deux fait leurs preuves en 1765.
Le conflit a pourtant eu lieu. Les relations se dégradent après la Jamaïque : les partisans de Harrison tiennent la récompense pour due selon la loi de 1714, les commissaires réclament une montre reproductible. Harrison s'adresse finalement au roi George III et au Parlement, qui lui accorde 8 750 livres en 1773. En tout, selon Betts, il a reçu 23 065 livres, frais compris, et s'estimait encore lésé.
Une montre se juge sur un nombre, des secondes contre une heure de référence. Une réponse de modèle admet souvent plusieurs formulations correctes et demande un jugement, humain ou automatique, qui se trompe aussi : OpenAI conseille de caler la notation automatique sur des relectures humaines. Le coût de la répétition s'est inversé : un voyage aux Antilles prenait des mois, un jeu d'essai se rejoue dans la journée. Enfin, la loi de 1714 ne connaissait ni jeu de test, ni échantillon, ni statistique ; elle fixait un écart et un voyage.
Une épreuve se décide avant le départ ; à l'arrivée, il ne reste qu'à lire l'écart.
Les commissaires de 1714 avaient écrit trente milles et une traversée. Il leur manquait une ligne sur ce que « praticable » voulait dire, et la dispute qui a suivi a duré jusqu'en 1773. Avant de comparer deux modèles, c'est celle que j'écris en premier.
Sources
- An Act for Providing a Publick Reward for such Person or Persons as shall Discover the Longitude at Sea, 12 Anne c. 15 (1714), texte imprimé en 1755, Internet Archive, consulté le 11 novembre 2026.
- Extrait du Longitude Act de 1714 (RGO 14/1, f. 11r), Royal Museums Greenwich et Cambridge University Library, consulté le 11 novembre 2026.
- H4, fiche d'objet, Royal Museums Greenwich, consulté le 11 novembre 2026.
- Longitude found: the story of Harrison's timekeepers, Royal Museums Greenwich, consulté le 11 novembre 2026.
- R. T. Gould, « Longitude and Chronometers of the 18th Century », Naval Historical Review, septembre 1995, consulté le 11 novembre 2026.
- J. J. O'Connor et E. F. Robertson, « English attack on the Longitude Problem », MacTutor, université de St Andrews, 1997, consulté le 11 novembre 2026.
- William B. Ashworth, « John Harrison », Linda Hall Library, 24 mars 2017, consulté le 11 novembre 2026.
- Jonathan Betts, « John Harrison (1693-1776) and Lt. Cdr Rupert T. Gould R.N. (1890-1948) », National Maritime Museum, consulté le 11 novembre 2026.
- Seb Falk, compte rendu de l'exposition Ships, Clocks & Stars: The Quest for Longitude, Science Museum Group Journal, n° 2, 2014, consulté le 11 novembre 2026.
- Jim Bennett, « The historian and the longitude », OUPblog, 24 mars 2017, consulté le 11 novembre 2026.
- Richard Dunn, « 1714 and all that? The Board of Longitude reconsidered », présentation de la conférence, Royal Museums Greenwich, consulté le 11 novembre 2026.
- Define success criteria and build evaluations, documentation d'Anthropic, consulté le 11 novembre 2026.
- Evaluation best practices, documentation d'OpenAI, consulté le 11 novembre 2026.
- La photographie sur Wikimedia Commons, Colonel Warden, CC BY-SA 3.0.