Biais du survivant : les bombardiers de Wald et les absents de vos données
En 1943, Abraham Wald estime la vulnérabilité des bombardiers à partir des seuls avions revenus, sans oublier ceux qui manquent. Sa méthode, plus précise que sa légende, s'applique à tout indicateur exposé au biais du survivant : compter ce qui est tombé en route.

En 1943, à l'université Columbia, le Statistical Research Group (1942-1945) travaille pour l'Applied Mathematics Panel du National Defense Research Committee américain. Le mathématicien Abraham Wald y rédige huit mémorandums sur une question : estimer la vulnérabilité d'un avion à partir des dégâts relevés sur les survivants.
On connaît le nombre d'avions envoyés au combat et, pour ceux qui reviennent, les coups reçus et leur emplacement. Les avions abattus ne laissent aucun relevé. Dans un exemple aux chiffres hypothétiques, 400 avions partent bombarder un objectif et 359 rentrent : 240 sans un coup, 68 avec un coup, 29 avec deux, 12 avec trois, 10 avec quatre.
Les 41 manquants n'ont rien à montrer, et Wald les fait pourtant entrer dans son calcul, par l'écart entre les avions partis et les avions rentrés. Le biais du survivant, ou biais de survivance, est l'erreur inverse : n'examiner que ce qui a passé une épreuve, et mesurer ainsi l'épreuve autant que la chose. Un délai moyen calculé sur les dossiers clos, un taux de satisfaction tiré des clients restés, un modèle entraîné sur les ventes conclues ont ce défaut. La correction consiste à compter ce qui est tombé en route.
Ce que Wald calcule avec les avions rentrés
Wald suppose d'abord que chaque coup a la même probabilité d'abattre l'avion. Les proportions d'avions rentrés avec zéro à quatre coups, rapportées aux 400 partis, suffisent alors à l'estimer : dans l'exemple, un avion survit à un coup avec une probabilité de 0,85.
Pour descendre aux parties de l'avion, l'exemple suppose que les coups tombent en proportion de la surface. Les moteurs font 26,9 % de la surface, mais ne portent que 19,3 % des 202 coups relevés sur les avions rentrés : selon le modèle, les coups manquants sont sur les avions perdus. Un avion touché au moteur survit avec une probabilité de 0,61, contre 0,95 au fuselage.
Le raisonnement compare ce qu'on observe à ce qu'on aurait observé si tous les avions étaient rentrés, à partir du nombre d'avions partis et d'une hypothèse nommée sur les absents.
Où vos indicateurs perdent des cas en route
Dans une entreprise, le hangar s'appelle tableau de bord, export ou fichier clients. Un indicateur ne voit que les cas qui ont atteint l'étape où on les mesure. Les autres sortent par des portes qu'on oublie :
- Les abandons : le prospect qui ne répond plus, le panier laissé en plan, la réclamation dont le client ne reparle pas. Sans date de fin, ils n'ont pas de délai.
- Les reprises à la main : le dossier que l'automatisation n'a pas su traiter, réglé par téléphone ou par email, hors de l'outil.
- Les cas jamais saisis : la demande arrivée par un canal que l'outil ne lit pas, l'appel noté sur un carnet.
- Les départs : le client parti l'an dernier quitte le fichier actif, avec ses réclamations et ses commandes.
- Les purges : l'archivage qui supprime les dossiers de plus de deux ans, les lignes « en erreur » filtrées avant le calcul.
Chacun de ces cas sort pour une raison liée à ce qu'on mesure. Les dossiers difficiles traînent, les clients mécontents partent, les cas atypiques font échouer l'automatisation. L'indicateur garde les cas faciles et devient flatteur sans qu'aucun calcul soit faux.
Le biais d'échantillonnage se joue à l'entrée : qui figure dans la liste, qui répond à l'enquête. Le biais du survivant se joue après : les cas sont entrés dans le système, puis l'ont quitté avant d'être comptés. Les deux peuvent se cumuler, mais ils se contrôlent à des endroits différents.
Reconstruire le dénominateur, étape par étape
Wald connaissait le nombre d'avions partis. Dans une entreprise, ce chiffre est rarement dans le tableau : il faut le reconstruire en remontant le parcours jusqu'à son entrée.
Une PME de soixante personnes, prise ici comme exemple hypothétique, affiche un délai moyen de résolution des réclamations de 3,2 jours sur le trimestre. Le chiffre est calculé sur les réclamations closes dans l'outil de tickets. En remontant le parcours, on trouve :
- Reçues : 600 réclamations, en additionnant les emails, le formulaire du site et le journal du standard.
- Enregistrées dans l'outil : 520. Les 80 autres sont arrivées par téléphone et n'ont jamais été saisies.
- Prises en charge : 480. Quarante sont restées sans réponse.
- Closes dans l'outil : 400. Les 80 dernières ont été réglées par email hors de l'outil, ou sont toujours ouvertes.
Les 3,2 jours décrivent donc 400 réclamations sur 600. Les 200 absentes ne ressemblent pas aux autres : ce sont les appels, les oubliées, les cas compliqués.
Reste à faire comme Wald : poser une hypothèse sur les absents, et la dire. Si les 200 réclamations manquantes avaient pris dix jours en moyenne (une hypothèse pessimiste, à discuter avec l'équipe), le délai moyen sur les 600 passerait à environ 5,5 jours. Je présente les deux chiffres côte à côte, avec les volumes de chaque étape : l'écart entre eux mesure ce que l'indicateur doit aux absents.
Quand une étape ne peut pas être reconstruite, faute de trace, écrivez-le sous l'indicateur : « hors réclamations téléphoniques ». Partir des données qu'on a, comme je le propose dans Commencer avec les données qu'on a, suppose de vérifier d'abord ce qu'elles ont perdu en route.
Un jeu d'entraînement qui ne contient que des réussites
Un modèle d'IA apprend sur des cas étiquetés, et l'étiquette n'existe souvent que pour les cas arrivés au bout. Une agence de douze personnes, dans un cas hypothétique, veut prévoir le délai de paiement de ses factures. Elle entraîne un modèle sur l'historique des factures payées, les seules qui ont une date de paiement. Les factures impayées ou passées en contentieux sortent du jeu d'entraînement, alors que ce sont les retards que le modèle devait apprendre à repérer. Il prévoira des délais trop courts, et il n'aura jamais vu le cas qui coûte le plus cher.
Les évaluations ont le même défaut. Un jeu de test construit à partir des conversations qu'un assistant a menées jusqu'au bout ne contient pas celles où l'utilisateur a abandonné, qui sont ses échecs. Ajouter des lignes n'y change rien si elles passent par le même filtre.
Avant d'entraîner ou d'évaluer, je pose la même question qu'au tableau de bord : à quelle étape une ligne entre-t-elle dans ce fichier, et quels cas n'y arrivent jamais ? La réponse se lit souvent dans la requête d'export, dans un filtre `statut = payé` ou `date_fin non vide` que personne ne relit.
Les mémorandums de 1943, sans la légende
Le récit courant veut que l'armée ait voulu blinder les zones criblées d'impacts, et que Wald lui ait conseillé de blinder les autres, puisque les avions touchés là n'étaient pas revenus. On l'illustre par une silhouette d'avion couverte de points rouges.
Les mémorandums, réédités en 1980 par le Center for Naval Analyses, sont des démonstrations de probabilités aux exemples hypothétiques. Ils estiment la vulnérabilité de chaque partie de l'avion sans dire où poser le blindage ; l'exemple qui accompagne le dernier note seulement que ses tables « peuvent servir de guides » pour le placer. La silhouette aux points rouges est une illustration moderne (Wikipédia en anglais la présente comme hypothétique), et l'expression « biais du survivant » n'apparaît pas dans les mémorandums.
Wald écrit aussi que sa solution vaut s'il est « connu a priori » que chaque coup a la même probabilité d'abattre l'avion ; avec ses données, relèvent Marc Mangel et Francisco Samaniego en 1984, on ne pouvait pas le tester. James Berger cite le cas des moteurs : un multimoteur peut voler avec un moteur coupé, si bien que le premier coup au moteur compte peu et que le second peut être fatal.
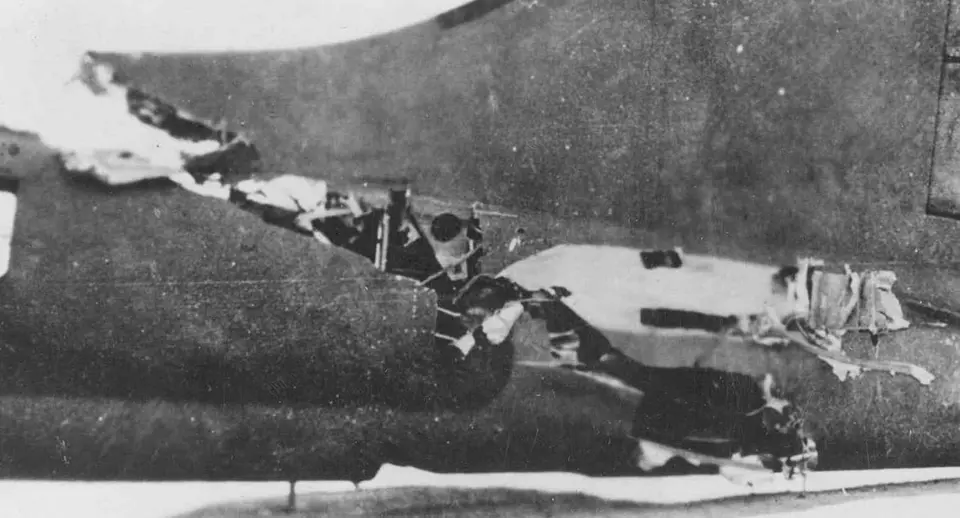
Le B-17 « All American III », photographié le 1er février 1943, est rentré presque coupé en deux par une collision : Wald calcule des probabilités, il ne dresse pas la carte des zones sans danger.
La transposition a ses limites. En 1943, le nombre d'avions partis était connu ; dans une entreprise, il faut souvent le reconstruire, et certaines étapes resteront dans le noir. Les enjeux ne se comparent pas : un délai mal estimé coûte une décision, un avion abattu coûtait un équipage. La méthode, elle, se transpose : partir du total, nommer l'hypothèse sur les absents, montrer combien la conclusion en dépend.
Avant de lire une moyenne, demandez combien de cas sont partis avant d'être comptés.
Dans l'exemple de Wald, les 41 avions perdus entrent dans la toute première équation, à côté des 359 rentrés. Dans votre tableau de bord, la ligne des absents mérite la même place : en haut, à côté de l'indicateur, avec son nombre.
Sources
- Abraham Wald, A Method of Estimating Plane Vulnerability Based on Damage of Survivors, huit mémorandums du Statistical Research Group pour le National Defense Research Committee (SRG 85 à 126, 1943), réédition du Center for Naval Analyses, CRC 432, juillet 1980. Le même document reproduit la dernière page de l'article de Mangel et Samaniego, le commentaire de Berger et leur réponse. Consulté le 11 novembre 2026.
- Marc Mangel et Francisco J. Samaniego, « Abraham Wald's Work on Aircraft Survivability », Journal of the American Statistical Association, vol. 79, n° 386, juin 1984, p. 259-267 (conclusion, p. 267), et réponse aux commentaires, p. 270-271, consulté le 11 novembre 2026.
- James O. Berger, « Abraham Wald's Work on Aircraft Survivability: Comment », Journal of the American Statistical Association, vol. 79, n° 386, juin 1984, p. 267-269, consulté le 11 novembre 2026.
- W. Allen Wallis, « The Statistical Research Group, 1942-1945 », Journal of the American Statistical Association, vol. 75, n° 370, 1980, p. 320-330, pour les dates du groupe, consulté le 11 novembre 2026.
- Survivorship bias, Wikipédia en anglais, légende de l'illustration aux points rouges, consulté le 11 novembre 2026.
- La photographie du B-17 « All American III » sur Wikimedia Commons, U.S. Air Force, domaine public, consulté le 11 novembre 2026.