Comment évaluer un modèle IA : le cheval Hans et les indices cachés
En 1904, à Berlin, un cheval frappe du sabot la réponse à des calculs, et treize personnes n'y trouvent aucune ruse. Pour évaluer un modèle IA, son histoire donne une méthode : chercher ce qui souffle la réponse, puis refaire le test sans.

En 1904, dans une cour pavée entourée d'immeubles, au nord de Berlin, un homme de plus de soixante ans interroge son cheval chaque jour vers midi, devant des visiteurs. Wilhelm von Osten a enseigné les mathématiques dans un lycée. Hans, un trotteur russe, répond en frappant du sabot droit : il additionne, compte les chapeaux des visiteurs, donne le jour de la semaine d'une date. Il répond aussi à des inconnus quand son maître n'est pas là.
Le 12 septembre 1904, treize hommes signent un rapport sur le cheval. Il y a parmi eux un directeur de cirque, le directeur du zoo de Berlin, un vétérinaire, deux officiers, un physiologiste et le psychologue Carl Stumpf. Ils s'étaient posé une question précise : celui qui interroge Hans lui fait-il des signes volontaires ? Leur réponse est non, à l'unanimité. Ils écartent aussi les signes involontaires d'un type déjà connu, et demandent une étude sérieuse.
Personne ne trichait, et le test ne mesurait pourtant pas le calcul. Quand vous cherchez comment évaluer un modèle IA, vous tombez sur la même difficulté : un bon score dit que les réponses sont justes, il ne dit pas par quel chemin elles sont arrivées.
Avec ou sans la réponse en tête
L'étude demandée a lieu du 13 octobre au 29 novembre 1904. Stumpf la dirige, Erich von Hornbostel tient les procès-verbaux, et Oskar Pfungst, collaborateur de Stumpf à l'Institut de psychologie de Berlin, mène les essais en faisant varier deux conditions.
La première : celui qui interroge connaît-il la réponse ? On montre au cheval des cartons portant des chiffres, que personne d'autre ne voit. Sur 49 essais où personne ne sait le chiffre, Hans en réussit 8 %. Sur 42 essais où l'interrogateur le connaît, 98 %.
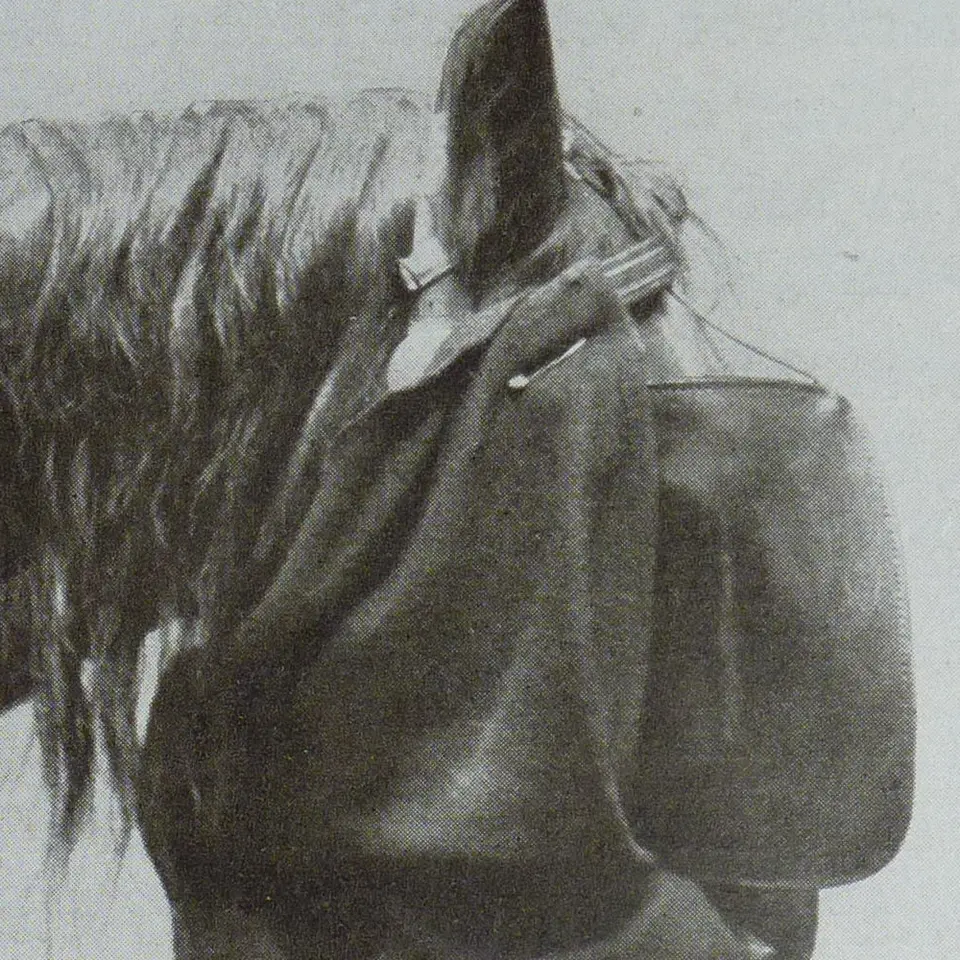
La seconde : le cheval voit-il l'interrogateur ? Avec des œillères de 15 centimètres de côté, Hans réussit 6 % des essais où il ne le voit pas (2 sur 35) et 89 % de ceux où il le voit (56 essais). Les premières œillères, plus petites, laissaient un tiers des essais dans le doute. En rangeant ces cas douteux avec ceux où le cheval ne voyait rien, comme le faisait von Osten, on aurait conclu, note Pfungst, que Hans n'avait besoin d'aucun signe visuel.
Reste à trouver le signe. Après la question, l'interrogateur penche légèrement la tête et le buste en avant, et le cheval se met à frapper. Au bon nombre, il relève la tête d'un petit coup, et Hans s'arrête. Au laboratoire, Pfungst joue le cheval face à vingt-cinq personnes : toutes sauf deux font ce mouvement, rarement plus ample qu'un millimètre, et lui-même peine à retenir le sien. Stumpf rend ses conclusions le 9 décembre 1904, Pfungst publie son livre en 1907 : Hans ne sait ni lire, ni compter, ni calculer.
Ce qu'un bon score peut mesurer d'autre
Les modèles d'IA ont leurs propres souffleurs, et plusieurs ont été documentés. En 2019, une équipe de Berlin examine un classifieur d'images qui obtenait de très bons scores sur un jeu de photos de référence. Pour reconnaître un cheval, il regardait surtout une mention de source imprimée dans un coin, présente sur environ une image de cheval sur cinq. Sans la mention, il ne reconnaissait plus le cheval ; ajoutée sur la photo d'une voiture, elle la faisait classer comme cheval. Les auteurs parlent eux-mêmes de comportement « Clever Hans », du surnom anglais de Hans.
En 2018, des chercheurs entraînent un modèle à repérer la pneumonie sur des radios venues de deux établissements, dont l'un comptait bien plus de malades que l'autre. Un réseau du même type savait reconnaître l'établissement d'origine d'une radio presque à coup sûr, entre autres grâce à un jeton de métal que les manipulateurs posent dans le coin de l'image. Le score du modèle (une aire sous la courbe, où 1 est parfait) passait de 0,931 sur des radios des deux établissements d'origine à 0,815 sur celles d'un troisième.
En 2024, une autre équipe fait écrire des problèmes d'arithmétique neufs, du même niveau et du même style qu'un test très utilisé. Certains modèles y perdent jusqu'à 8 % de réussite, ce qui suggère qu'ils avaient en partie retenu les questions du test d'origine. Les modèles les plus avancés perdent peu.
Dans un projet de PME, les souffleurs sont plus ordinaires :
- Les cas déjà vus : les documents qui ont servi à écrire les consignes ou les exemples du prompt se retrouvent dans le test.
- Le format : les factures d'un même fournisseur placent toujours la date au même endroit, et le nom du fichier dit déjà la catégorie.
- La formulation : la question contient une partie de la réponse, ou la liste des choix possibles la trahit.
- Le juge qui sait : la personne qui note les réponses sait quelle version de l'assistant les a produites, et elle a une préférence.
- La reprise à la main : quelqu'un corrige les sorties avant qu'on les compte, sans que la correction soit déclarée.
Les limites de l'exemple du cheval
Hans observait une personne en chair et en os. Un modèle n'a personne à regarder : ses souffleurs sont des régularités dans les données, une mention dans un coin, une question déjà lue. Le parallèle tient au protocole, qui laisse un chemin de traverse ; le mécanisme, lui, n'a rien de commun.
Pfungst n'a pas construit de jeu d'évaluation au sens actuel, et il ne parlait ni de double aveugle ni de généralisation. Il a croisé deux conditions et compté les bonnes réponses, dans une cour exposée à la pluie et aux curieux, avec un propriétaire qui interrompait les essais.
La légende en a fait une histoire d'escroc et de cheval idiot. Stumpf écrit que si von Osten avait dressé Hans exprès à de tels signes, il aurait été à la fois un fraudeur et un génie, et qu'il ne fut probablement ni l'un ni l'autre. Le cheval percevait des mouvements qui échappaient à des observateurs exercés. Von Osten a refusé ces conclusions et interdit toute nouvelle expérience. Il est mort en 1909. Quant à la commission, l'article Wikipédia en anglais la dit nommée par l'administration scolaire, alors que Stumpf précise que personne ne l'avait mandatée.
Refaire le test sans l'indice
La méthode de Pfungst se transpose : pour chaque chose qui pourrait souffler la réponse, faire tourner une deuxième version du test où elle manque, puis comparer.
Je commence par écrire la compétence en une phrase, avec le type de document : « trouver le montant TTC sur une facture fournisseur que l'assistant n'a jamais vue ». Tant que cette phrase reste floue, on ne sait pas ce qui compte comme indice.
Prenez une PME de soixante personnes (le cas et ses chiffres sont hypothétiques) qui teste un assistant qui classe les tickets du support. Sur les 200 tickets qui ont servi à mettre au point ses consignes, il en classe bien 94 %. Sur 200 tickets du mois suivant, que personne n'a regardés, il tombe à 71 %. Les 23 points d'écart mesurent ce que le premier test récompensait en plus de la compétence : des tickets connus, des tournures familières. Une partie de l'écart peut aussi venir d'un mois différent, mais c'est le second score qui ressemble à l'usage réel.
Je confie aussi le choix des cas de test à quelqu'un qui n'a pas écrit les consignes. Celui qui a mis au point le prompt retient, sans le vouloir, des cas qui lui ressemblent, comme les interrogateurs de Hans relevaient la tête sans s'en apercevoir.
Faites aussi le test inverse. Le classifieur de 2019 voyait un cheval dans une voiture dès qu'on y ajoutait la mention de source. Donnez de même au modèle l'indice seul : un fichier nommé « urgent » dont le contenu ne l'est pas, une question qui suggère une réponse fausse. Si la réponse suit l'indice, le score reposait en partie sur lui.
Enfin, rangez les cas douteux à part. Une réponse à moitié juste, un document illisible, un ticket qui relève de deux catégories : les compter du côté qui arrange revient à faire ce que faisait von Osten avec ses petites œillères.
Un test ne prouve une compétence que s'il interdit de réussir sans elle.
Dans son rapport du 9 décembre 1904, Stumpf note que Pfungst obtenait à volonté toutes les réactions du cheval par des mouvements volontaires, sans même poser la question. Faites l'essai avec votre modèle : retirez la question, laissez l'indice. S'il réussit encore, vous savez ce que mesurait votre score.
Sources
- Oskar Pfungst, Clever Hans (The Horse of Mr. von Osten), traduction de Carl L. Rahn, New York, Henry Holt, 1911, avec l'introduction de Carl Stumpf et les rapports du 12 septembre et du 9 décembre 1904 en annexe, Project Gutenberg, consulté le 11 novembre 2026.
- Oskar Pfungst, Das Pferd des Herrn von Osten (Der kluge Hans), Leipzig, Johann Ambrosius Barth, 1907, fac-similé sur Internet Archive, consulté le 11 novembre 2026.
- Stefano Vezzani, « The Elberfeld Horses », Skeptical Inquirer, vol. 37, n° 2, mars-avril 2013, consulté le 11 novembre 2026.
- Clever Hans, Wikipédia en anglais, consulté le 11 novembre 2026.
- Sebastian Lapuschkin et al., « Unmasking Clever Hans predictors and assessing what machines really learn », Nature Communications, 2019, consulté le 11 novembre 2026.
- John R. Zech et al., « Variable generalization performance of a deep learning model to detect pneumonia in chest radiographs », PLOS Medicine, 2018, consulté le 11 novembre 2026.
- Hugh Zhang et al., « A Careful Examination of Large Language Model Performance on Grade School Arithmetic », NeurIPS 2024, version 4 sur arXiv, consulté le 11 novembre 2026.
- La photographie sur Wikimedia Commons, domaine public.