Produire des vidéos stickman pour YouTube sans clé d'API, avec Claude Code
Un bonhomme en bâtons dessiné à la main, une voix, des sous-titres : le format des chaînes YouTube sans visage. Cette base de production le fait avec Claude Code, HyperFrames et des outils locaux, sans aucun service payant.
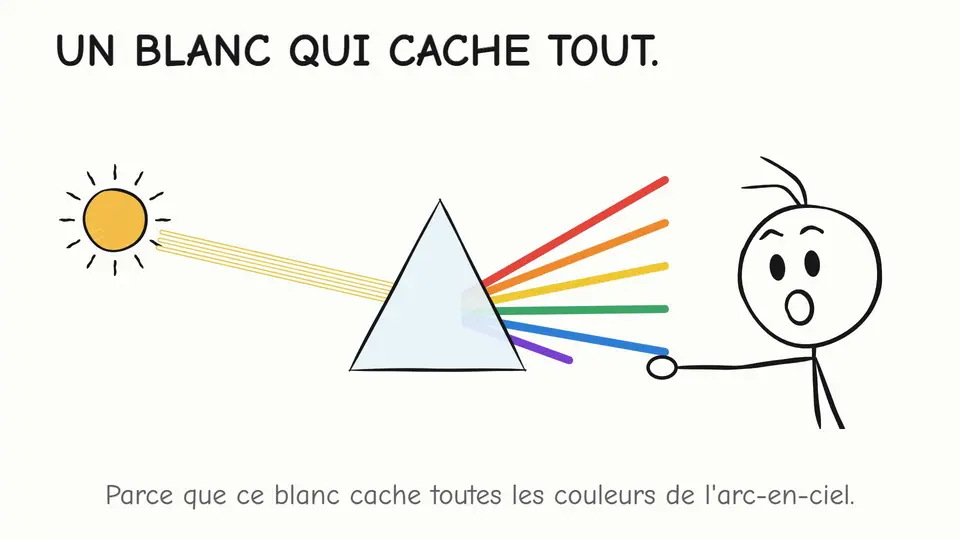
Les chaînes YouTube « faceless » racontent sans montrer personne. Le style stickman en est une variante : un personnage en bâtons, dessiné comme à la main, qui réagit à ce que dit la voix. Ce projet est une base pour produire une ou plusieurs chaînes de ce genre. Aucune chaîne n'est encore publiée : le dossier contient le moteur, un modèle de chaîne et un laboratoire d'essais.
Le projet d'origine et le kit
Le point de départ est Stickman Video Director, un projet libre sous licence MIT qui décrit comment réaliser ces vidéos : styles, jeu du personnage, règles de production. Son dépôt est cloné tel quel dans le moteur, comme référence, et n'est jamais modifié : il se met à jour à part.
J'en reprends les règles et quelques fonctions, sans ce qui demande un service externe : le projet d'origine propose un mode qui fait appel à un générateur d'images, et ce mode est exclu ici. Tout le reste tourne sur l'ordinateur : l'animation est un projet HyperFrames, un outil qui transforme une page HTML animée en vidéo, la voix vient de la chaîne de secours déjà utilisée dans OPUS MOTION (voix clonée par Voicebox, puis edge-tts, puis Piper), et les bruitages sont générés par un script, d'après ceux du projet d'origine.
Le kit stickman contient le personnage, un squelette en SVG avec ses poses et ses expressions, des fonctions pour cligner des yeux, courir, garder un léger mouvement de vie. Les objets se tracent avec un module d'encre qui imite le trait au crayon, hachures comprises, plutôt qu'avec un trait uniforme. Une planche du laboratoire montre toutes les poses et expressions disponibles.
Fabriquer une vidéo
Une commande crée le dossier de la vidéo. J'écris ou fais écrire le script d'après la charte de la chaîne, et je le valide. La narration produit ensuite la voix, le minutage de chaque mot et les sous-titres. Claude écrit les scènes en les calant sur ces mots : l'image suit la voix, jamais l'inverse.
Avant de rendre la vidéo entière, HyperFrames vérifie le projet et tire des images à des instants choisis, que Claude regarde. Puis je valide un extrait de vingt secondes avec le son, avant le rendu complet.
Les règles de production
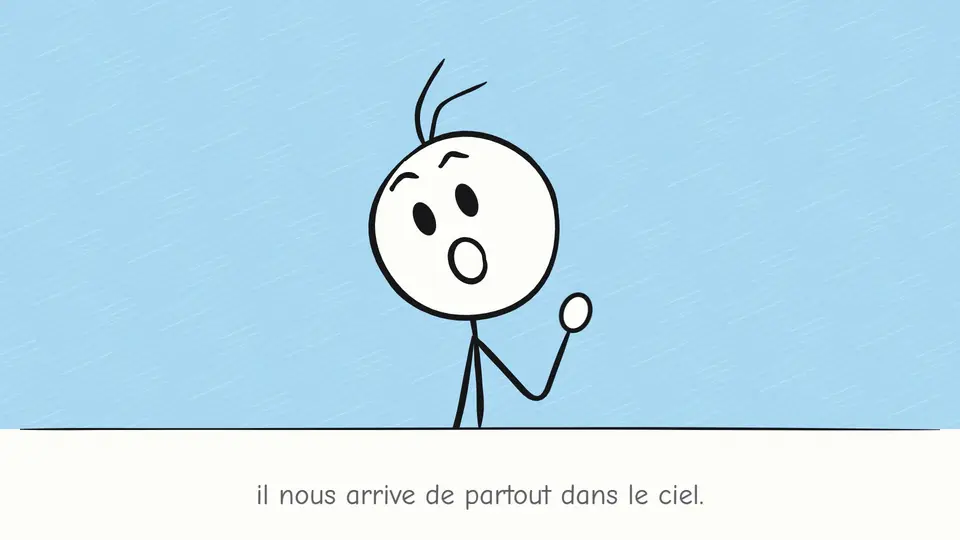
Les règles reprises du projet d'origine fixent le rythme : les trente premières secondes doivent accrocher, l'image principale ne reste jamais plus de deux secondes et demie sans progresser, et les sous-titres suivent la parole naturelle. Le style ajoute les siennes : cadrer serré, la tête dominante ; beaucoup de blanc ; une idée par plan ; le texte de scène en Comic Neue gras.
Une autre règle interdit d'inventer un chiffre, un témoignage ou une capacité de produit pour renforcer l'accroche. Quand la vidéo part d'un article, un chiffre n'est repris que si sa source est identifiée, et le texte source reste dans le dossier de la vidéo.
Le minutage et l'orthographe des sous-titres
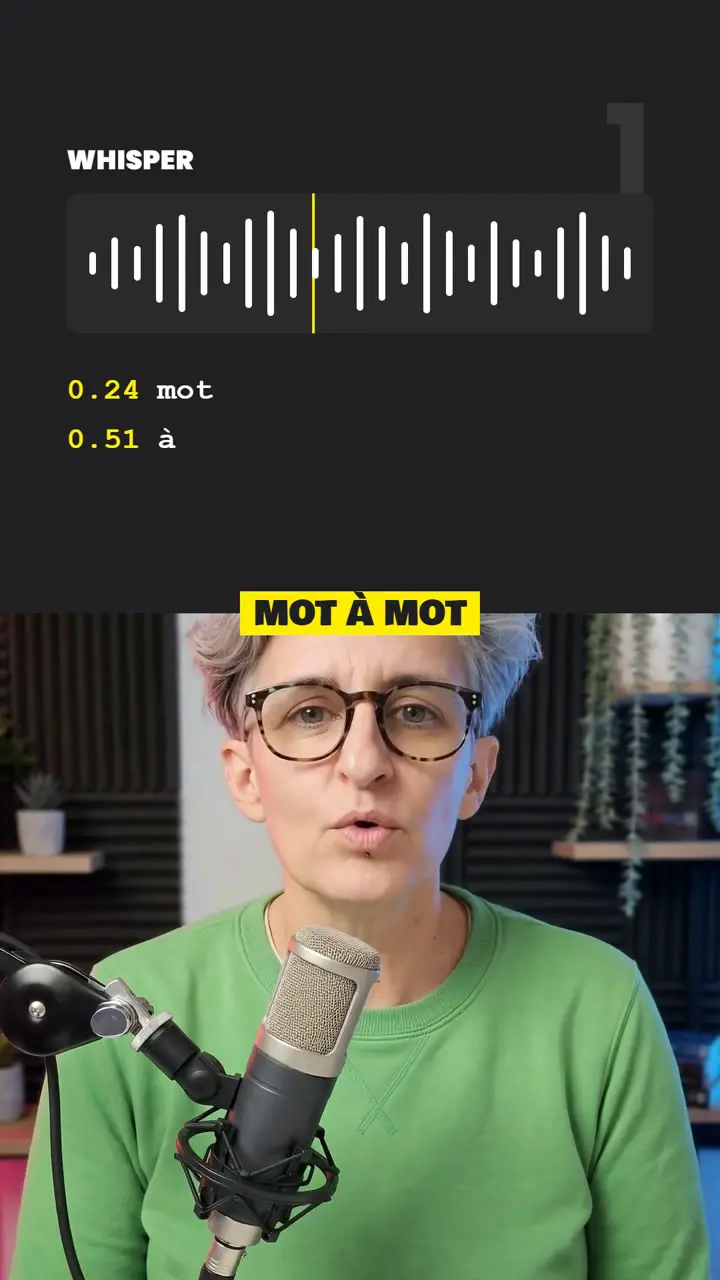
Le minutage des mots vient de Whisper, qui transcrit la narration. Mais Whisper écrit mal ce qu'il entend : « Hyper Frames » en deux mots, « où » devient « ou ». Le script de minutage pose une règle simple, écrite en tête du fichier : Whisper donne le temps, le script donne l'orthographe. Les sous-titres affichent le texte voulu, aux instants mesurés : le script aligne les deux suites de mots et garde l'orthographe du texte.
Le même fichier note deux impasses mesurées. Donner la phrase attendue à Whisper en guise d'indice le pousse à croire qu'il l'a déjà transcrite : il invente alors des formules apprises ailleurs, comme « Sous-titres réalisés par la communauté d'Amara.org », au lieu de transcrire la voix. Lui souffler toute la phrase comme mots-clés produit le même genre d'invention.
Whisper donne le temps, le script donne l'orthographe.
Les décisions en route
- Aucune clé d'API : rendu, voix et sous-titres tournent sur l'ordinateur, et le mode qui demande un générateur externe est écarté.
- Une copie du kit par vidéo : améliorer le personnage ne modifie pas les vidéos déjà faites.
- Une voix par chaîne : la charte de chaque chaîne note la voix choisie, et chaque génération se vérifie.
- Un laboratoire séparé : les essais vivent dans un dossier qui n'est jamais publié.
La base est en cours. Le laboratoire contient une vidéo sur la couleur du ciel, une autre sur l'automatisation des emails et la planche du personnage ; la première chaîne reste à ouvrir.