Biais d'échantillonnage : les 2,4 millions de réponses du Literary Digest
En 1936, le Literary Digest reçoit près de 2,4 millions de bulletins et annonce la défaite de Roosevelt. C'est l'exemple de manuel du biais d'échantillonnage, souvent mal raconté. Bien lu, il apprend à vérifier qui a répondu avant de publier un pourcentage.

Le 22 août 1936, l'hebdomadaire américain Literary Digest lance son sondage pour l'élection présidentielle. Il a désigné le bon vainqueur aux quatre élections précédentes. Dix millions de bulletins partent par la poste, adressés à la main. Les adresses viennent des annuaires téléphoniques, de listes de clubs et d'associations, de listes électorales et d'autres fichiers.
Le numéro du 31 octobre titre sur deux nombres : Landon, 1 293 669 ; Roosevelt, 972 897. Le républicain Alf Landon obtiendrait 54 % des voix et 370 grands électeurs, le président sortant Franklin Roosevelt 41 %. La rédaction précise que ces chiffres ne sont « ni pondérés, ni ajustés, ni interprétés ». Quelques jours plus tard, Roosevelt est réélu avec plus de 60 % des voix et 523 grands électeurs sur 531 : Landon ne gagne que le Maine et le Vermont.
Le magazine, vendu, cesse de paraître deux ans plus tard selon Dominic Lusinchi. Son sondage sert depuis d'exemple de biais d'échantillonnage dans les manuels de statistique : ceux qui ont répondu ne ressemblaient pas à l'électorat, et leur nombre n'y changeait rien. La même question vaut pour un pourcentage tiré d'une enquête interne, d'un formulaire de satisfaction ou de l'export d'un outil : comment les gens sont-ils entrés dans l'échantillon, et lesquels n'ont pas répondu ?
Vingt points d'erreur, une marge de 0,6 point
Avec autant de bulletins, l'aléa d'échantillonnage ne pesait presque rien : les statisticiens Sharon Lohr et J. Michael Brick évaluent la marge d'erreur d'échantillonnage à 0,6 point en valeur médiane, État par État. Sur les voix des deux grands partis, le Digest donnait pourtant 42,9 % à Roosevelt, qui en obtint 62,5 %, selon Lusinchi. Chaque bulletin de plus resserrait l'estimation autour de la même valeur fausse.
Les manuels reprennent l'explication de George Gallup (1938) : une liste tirée des annuaires téléphoniques et des fichiers d'automobilistes, donc de ménages aisés et républicains. Les réanalyses, fondées sur un sondage Gallup de mai 1937 qui demandait qui avait reçu et renvoyé le bulletin, ou sur les chiffres du Digest, nuancent cette thèse sans s'accorder :
- Squire (1988) : les propriétaires de téléphone ou de voiture votaient majoritairement Roosevelt ; il attribue environ 11 points d'erreur à la liste et 7 à la non-réponse, un calcul que Lusinchi conteste.
- Lusinchi (2012) : 53,9 % de ces propriétaires ont voté Roosevelt ; il attribue 5,9 points à la liste et 13,7 à la non-réponse, les partisans de Landon ayant renvoyé leur bulletin plus souvent.
- Lohr et Brick (2017) : ils retiennent la combinaison d'une liste imparfaite et d'un faible taux de réponse. Redressées sur le vote de 1932, que le bulletin demandait, les réponses donnent Roosevelt vainqueur, encore très loin de son vrai score.
Aucune des trois ne fait de la liste la seule cause.
Le même filtre dans vos enquêtes et vos exports
Une enquête d'entreprise passe les deux mêmes portes que le bulletin de 1936. La liste décide qui peut recevoir la question, la réponse décide qui sera compté. Le filtre agit au moment où l'on interroge ; le biais du survivant, voisin, agit plus tard, en retirant les cas qui ont échoué en route. Les situations les plus courantes :
- L'enquête de satisfaction par email : elle part vers les clients dont l'adresse est dans le CRM. Ceux qui commandent par téléphone ou au comptoir n'ont jamais pu répondre.
- Le questionnaire intégré à un outil : il ne touche que les personnes qui l'ouvrent encore. Celles qui l'ont abandonné, souvent les plus déçues, sont hors de la liste.
- Les avis et les tickets : ils viennent de clients qui ont une raison d'écrire, très contents ou très mécontents. Le client satisfait et silencieux n'y apparaît pas.
- L'export d'usage d'un assistant IA : il décrit les salariés qui l'ont activé, pas ceux qui n'en ont ni l'accès ni l'usage.
Pour juger du danger, une question suffit : la raison de répondre a-t-elle un lien avec la réponse ? En 1936, l'hostilité au New Deal semble avoir poussé à renvoyer le bulletin, selon Lusinchi, et c'est ce vote que le sondage mesurait. Dans un questionnaire sur un outil, l'enthousiasme pousse à répondre, et c'est l'enthousiasme qu'on mesure. Plus ce lien est fort, moins le pourcentage des répondants dit quelque chose des autres.
Dans une PME hypothétique de soixante salariés, un assistant IA a été déployé au printemps, et la direction veut savoir s'il fait gagner du temps. Le questionnaire, affiché dans l'assistant lui-même, recueille 21 réponses, dont 17 disent gagner du temps : 81 %. Le chiffre est exact pour les répondants. Il ne dit rien des 39 autres salariés, dont une partie n'ouvre plus l'outil et n'a jamais vu la question.
On peut au moins borner le résultat. Si aucun des 39 ne gagne de temps, la part réelle est de 17 sur 60, soit 28 %. Si tous en gagnent, elle monte à 56 sur 60, soit 93 %. Une fourchette de 28 à 93 % ne permet pas de décider s'il faut étendre l'outil ; elle dit qu'il faut aller chercher les absents. Lusinchi tire de 1936 une règle du même ordre : une enquête dont le taux de réponse est faible est probablement biaisée.
Pas d'élection pour corriger votre enquête
Deux points de la légende ne tiennent pas. Le magazine connaissait son penchant : après l'élection, il écrit que ses sondages ont « toujours » compté trop de républicains depuis 1920, relèvent Lohr et Brick, et il a gardé ses chiffres bruts surtout parce qu'ils avaient donné le bon vainqueur en 1928 et en 1932. Gallup, lui, n'a pas gagné grâce à un tirage au hasard : il travaillait par quotas, que ses enquêteurs remplissaient largement à leur guise selon Lusinchi, et il donnait à Roosevelt près de sept points de moins que son résultat.
Le Digest a eu ce qui manquera à votre enquête : quelques jours plus tard, une élection a donné le vrai chiffre. Une enquête de satisfaction ou un export d'usage ne rencontre jamais son jour de vote, et personne ne vous dira de combien vous vous êtes trompé. L'écart ne se voit que si vous le cherchez, en comparant les répondants à ce que vous savez de tout le monde.
Les ordres de grandeur diffèrent aussi. Lohr et Brick notent que les 24 % de réponse de 1936 dépassent ceux de beaucoup de sondages actuels : la non-réponse pèse aujourd'hui plus lourd. Et les petits effectifs d'une PME ajoutent le hasard au biais : sur vingt réponses, une seule fait bouger le pourcentage de cinq points.
Avant de publier un pourcentage
J'écris d'abord la population visée, en une phrase, avant de lire une seule réponse : « tous les salariés », « les clients qui ont commandé en 2026 ». Puis deux nombres : combien de personnes pouvaient recevoir la question, combien ont répondu. L'écart entre la population visée et le premier nombre montre ce que la liste a oublié ; l'écart entre les deux nombres, ce que la non-réponse a pu déformer.
Si vous connaissez une caractéristique de toute la population (le service, l'ancienneté, le type de client), comparez sa répartition chez les répondants et dans l'ensemble. Un écart signale le biais et permet de redresser, comme Lohr et Brick avec le vote de 1932. Leur exemple montre aussi la limite : le redressement suppose que, dans chaque groupe, ceux qui se taisent pensent comme ceux qui répondent. En 1936, il ramène le bon vainqueur sans approcher le bon écart.
Pour une enquête qui revient chaque trimestre, suivez le taux de réponse à côté du résultat, vague après vague. Si la satisfaction monte pendant que le taux de réponse baisse, les mécontents ont peut-être cessé de répondre : vérifiez-le avant d'annoncer une amélioration.
Certaines sources n'ont pas de liste du tout : les avis en ligne, les messages spontanés au support. Sans dénominateur, aucun taux de réponse ne se calcule et aucun pourcentage ne se défend. Ces retours servent à repérer des problèmes et à les décrire ; pour les compter, il faut une enquête adressée à une liste connue.
Quand l'enjeu le justifie, allez chercher les absents. Tirez au hasard cinq ou six non-répondants, joignez-les par un autre canal (un appel, un échange de cinq minutes au café) et comparez leurs réponses à celles du premier groupe. Don Cahalan a fait l'équivalent après l'élection, à Cedar Rapids, dans l'Iowa : il a tiré des noms à intervalle régulier dans la liste du Digest, les a interrogés par téléphone et a obtenu 80 % de réponse.
Le nombre de réponses dit combien de personnes ont parlé ; il ne dit rien de celles qui se sont tues.
Le 31 octobre 1936, le jour où le Digest publiait ses résultats, une lettre au New York Times signée « Amateur Statistician » notait que ce quart de bulletins revenus s'était, pour ainsi dire, choisi lui-même, et qu'on ne pouvait pas mesurer l'erreur à partir des seuls retours. J'en garde une ligne sous chaque chiffre d'enquête : combien de personnes ont reçu la question, combien ont répondu.
Sources
- Sharon L. Lohr et J. Michael Brick, « Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll », Statistics, Politics and Policy, 8(1), 2017, p. 65-84, qui cite les numéros du Literary Digest du 22 août, du 31 octobre et du 14 novembre 1936 et la lettre « Amateur Statistician » au New York Times du 31 octobre 1936, consulté le 11 novembre 2026.
- Dominic Lusinchi, « "President" Landon and the 1936 Literary Digest Poll: Were Automobile and Telephone Owners to Blame? », Social Science History, 36(1), 2012, p. 23-54, qui discute Cahalan et Meier (1939) et Squire (1988), consulté le 11 novembre 2026.
- Beth Chance, Andrew Kerr et Jett Palmer, « Taking the Next Step in Exploring the Literary Digest 1936 Poll », Journal of Statistics and Data Science Education, 2024, manuscrit accepté, consulté le 11 novembre 2026.
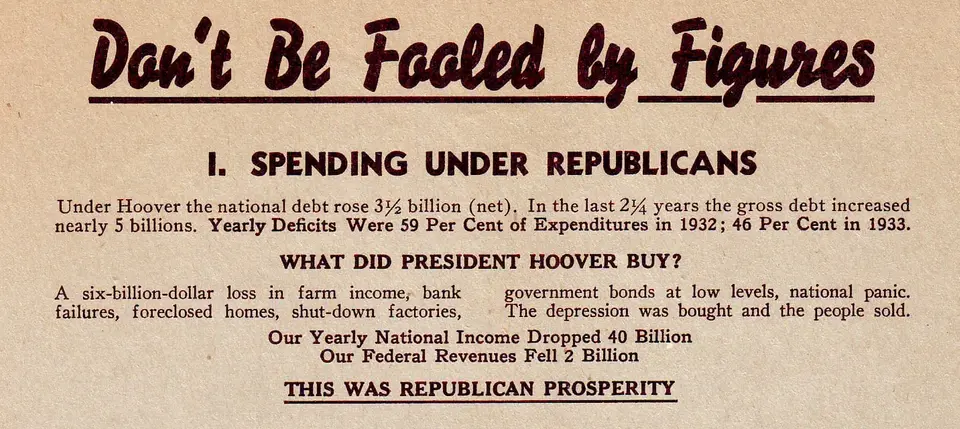
- Le tract « Don't Be Fooled by Figures » sur Wikimedia Commons, Democratic National Campaign Committee, 1936, domaine public aux États-Unis, consulté le 11 novembre 2026.