Le RAG en entreprise : ce qui tient vraiment
En 1895, deux Belges commencent à ranger tout le savoir du monde sur des fiches. Leur méthode explique mieux que n'importe quel tutoriel pourquoi un assistant IA branché sur vos documents répond bien, ou répond n'importe quoi.

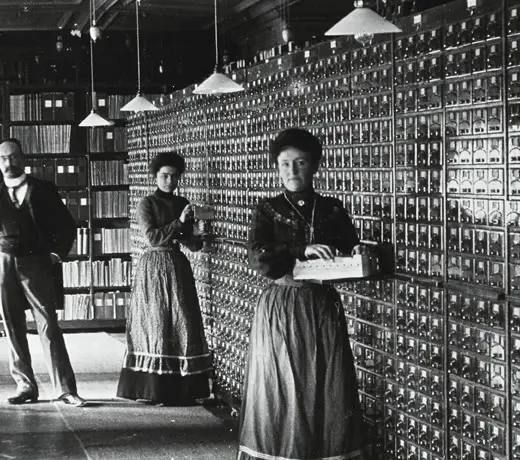
En 1895, à Bruxelles, Paul Otlet et Henri La Fontaine lancent un projet démesuré : le Répertoire bibliographique universel. L'idée est de recenser tout ce qui a été publié, sur des fiches de format identique, classées selon un système qu'ils développent pour l'occasion, la classification décimale universelle. À la fin de la première année, le répertoire compte déjà 400 000 fiches. Le Mundaneum, à Mons, en conserve aujourd'hui plusieurs millions.
La photo ci-dessus montre la salle du répertoire vers 1900. Des murs entiers de tiroirs, et des employées qui rédigent, vérifient et classent. Ce qui rendait ce répertoire utile, ce n'était pas la quantité de fiches. C'était la discipline de chaque fiche.
Ce qu'est un RAG, sans jargon
Un RAG, pour retrieval augmented generation, est un assistant IA qui répond à partir de vos propres documents. Quand vous posez une question, le système cherche d'abord les passages les plus proches dans votre base, puis il les donne au modèle de langage, qui rédige une réponse à partir d'eux.
Autrement dit, c'est un fichier d'Otlet avec un rédacteur au bout. Et comme pour le fichier, la qualité de la réponse dépend presque entièrement de ce qui a été rangé, et de la façon dont on l'a rangé.
Pourquoi tant de projets déçoivent
Le scénario le plus courant ressemble à ceci. On rassemble des centaines de documents dans un dossier : procédures, comptes rendus, offres commerciales, anciennes versions comprises. On les donne à un outil qui les découpe en morceaux de taille fixe. On pose une question. La réponse est fluide, plausible, et parfois fausse, parce qu'elle s'appuie sur une procédure de 2021 remplacée depuis.
Le modèle n'y est pour rien. Il a fait ce qu'on lui demandait : rédiger à partir des passages qu'on lui a donnés. Le problème est en amont, dans le répertoire.
Ce qui tient vraiment
Les projets qui fonctionnent dans la durée ont presque tous les mêmes caractéristiques. On les retrouve, à peu de chose près, dans les règles du répertoire de 1895 :
- Un découpage qui respecte le sens. On coupe par section, par question, par article de procédure. Pas tous les 500 caractères au milieu d'une phrase.
- Des métadonnées sur chaque morceau. La date, la version, l'auteur, le service concerné. Elles permettent d'écarter ce qui est périmé et de filtrer par contexte.
- Une seule version en vigueur. Les anciennes versions sont archivées hors de la base, ou explicitement marquées comme telles.
- Des citations obligatoires. Chaque réponse indique les documents utilisés, avec un lien. L'utilisateur peut vérifier, et repère vite une source douteuse.
- Des droits respectés. L'assistant ne doit pas répondre à un salarié avec un document qu'il n'aurait pas le droit d'ouvrir.
- Un propriétaire du corpus. Une personne est chargée d'ajouter, de mettre à jour et de retirer les documents. Sans elle, la base se dégrade en quelques mois.
Le droit de dire « je ne sais pas »
Un dernier point, qui fait la différence pour les utilisateurs : un bon assistant documentaire sait refuser. Si aucun passage pertinent n'est trouvé, il doit le dire, plutôt que de compléter avec ce que le modèle sait en général. C'est une consigne à écrire explicitement, et à vérifier dans le jeu de test.
Un assistant branché sur vos documents ne sera jamais meilleur que le classement de ces documents.
Otlet rêvait d'un réseau qui permettrait à chacun d'interroger le savoir à distance. Il avait compris l'essentiel bien avant les moteurs de recherche : chercher n'est utile que si l'on a d'abord rangé.
Sources
- The Répertoire Bibliographique Universel, an Analog Search Engine, History of Information, consulté le 10 novembre 2026.
- Le Mundaneum, Visit Mons, consulté le 10 novembre 2026.
- Il y a 130 ans, l'ancêtre d'internet et des moteurs de recherche était créé en Belgique, Slate.fr, consulté le 10 novembre 2026.
- La photographie sur Wikimedia Commons, domaine public.