Ouvrir un fichier Parquet ou XML dans le navigateur, sans rien installer
Un fichier Parquet ne s'ouvre pas d'un double clic, et un gros XML se lit mal dans un éditeur de texte. Mes visionneuses tiennent chacune en un seul fichier HTML : on y glisse le fichier, la page le lit en mémoire, et rien ne part sur le réseau.
Parquet est un format de fichier pour les données en colonnes, compressé, très utilisé dans les outils de data. Il ne s'ouvre ni dans un tableur ni dans un éditeur de texte : il faut un programme qui sache le décoder. Le XML, lui, s'ouvre partout, mais un fichier de quelques mégaoctets devient un mur de balises imbriquées.
Les visionneuses de l'atelier répondent à ces deux cas avec la même recette : un seul fichier HTML, ouvert dans le navigateur, dans lequel on glisse le fichier à lire, sans rien installer.
Un seul fichier HTML
La visionneuse Parquet tient en un fichier d'environ 210 ko. Elle embarque hyparquet, une bibliothèque JavaScript qui lit le format Parquet, et ses décompresseurs (Snappy, Gzip, Brotli, Zstandard), dont une partie est compilée en WebAssembly et rangée directement dans la page. Elle ne contient aucune adresse web : la page n'appelle aucun serveur et fonctionne sans connexion.
Les visionneuses XML suivent la même règle. Il y en a plusieurs, parce que chacune est écrite pour un format précis : elle sait quelles balises forment une ligne et lesquelles en sont le détail.
Lire sans rien envoyer
Le fichier est glissé dans la page, ou choisi avec un bouton, et aucune donnée ne part sur le réseau. Je peux donc me servir des visionneuses XML sur des fichiers de travail, que je ne peux pas déposer dans un service en ligne. Ce carnet n'en montre rien : les captures viennent d'un fichier de ventes inventé.
Ce que montre la visionneuse Parquet
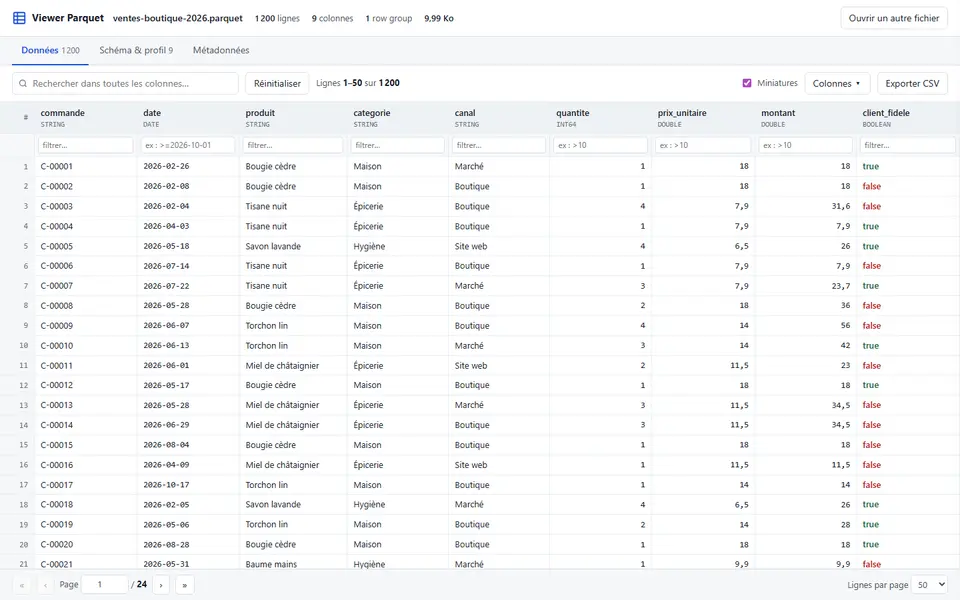
La page s'ouvre sur un tableau, cinquante lignes par page, avec ce qu'on attend d'un tableur pour explorer :
- La recherche : un champ cherche dans toutes les colonnes à la fois.
- Les filtres par colonne : chaque colonne a son champ, qui accepte des comparaisons comme « >10 » ou « >=2026-10-01 ».
- Les miniatures : la page repère, sur un échantillon de deux cents valeurs, les colonnes qui contiennent des adresses web ou des images, et peut afficher les images en petit dans le tableau.
- L'export CSV : il reprend les lignes filtrées et les colonnes visibles, avec le point-virgule comme séparateur, celui qu'attend Excel en français.
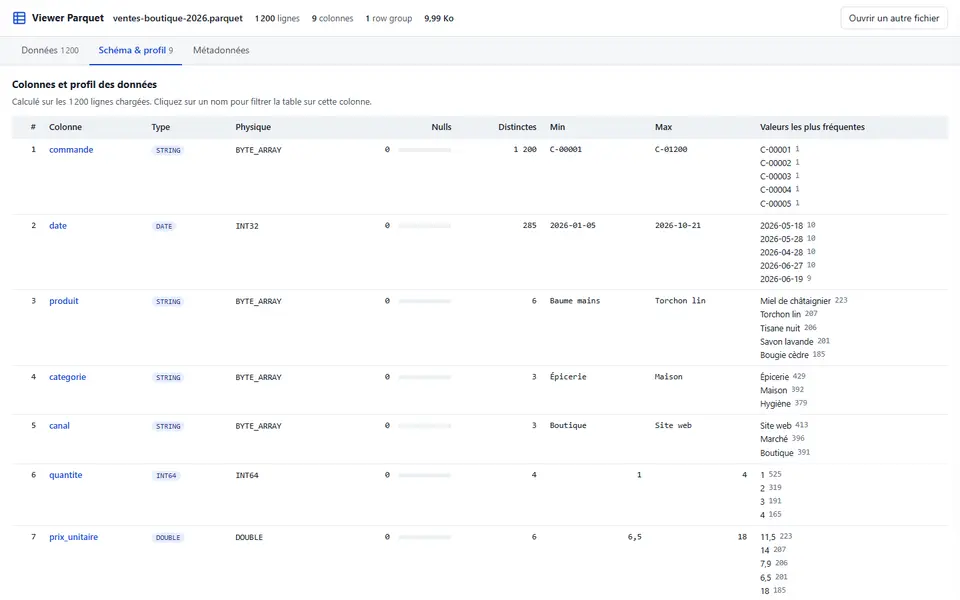
Le deuxième onglet profile les données. Pour chaque colonne : son type, son stockage physique, le nombre de valeurs vides, le nombre de valeurs distinctes, le minimum, le maximum et les valeurs les plus fréquentes. Un clic sur le nom d'une colonne renvoie au tableau, filtré sur elle. Un troisième onglet affiche les métadonnées du fichier.
Un garde-fou protège la mémoire du navigateur : au-delà d'un million de lignes, la visionneuse ne décode que le premier million.
Les pièges du XML
Le premier piège est l'encodage. Beaucoup de fichiers XML ne sont pas en UTF-8 : ils déclarent leur encodage dans leur première ligne, par exemple ISO-8859-1. Lus comme de l'UTF-8, leurs accents sortent en caractères illisibles. La plus récente des visionneuses lit donc d'abord les trois cents premiers octets, y cherche la déclaration « encoding », puis décode tout le fichier avec l'encodage annoncé. Sans déclaration, elle suppose l'UTF-8.
Le second piège est le fichier mal formé. Le DOMParser du navigateur, qui transforme le texte en arbre de balises, ne signale pas l'erreur en s'arrêtant : il renvoie un document qui contient une balise d'erreur. Chaque visionneuse cherche cette balise avant d'afficher quoi que ce soit, pour ne pas montrer un fichier à moitié lu comme s'il était complet.
Les décisions en route
- Un fichier plutôt qu'une application : il s'envoie et s'ouvre d'un double clic, sans rien à mettre à jour.
- Les bibliothèques dans la page : la visionneuse Parquet ne dépend d'aucun serveur de bibliothèques, et continue de marcher le jour où l'un d'eux disparaît.
- Une limite écrite : le million de lignes est une constante en tête du code, facile à changer.
- Des données inventées pour les captures : les fichiers réels restent sur l'ordinateur.
Un fichier confidentiel peut être lu dans un navigateur, à condition que la page ne l'envoie nulle part.
Les visionneuses sont en service. Pour un nouveau format, je repars de la même base et j'écris les vues que son contenu demande.